
| 17 сент. 2026 г. — 9:00 PT
Разработка Android Bench от Google продолжается: представлена версия 2.0, которая отражает способность искусственного интеллекта справляться с более сложными задачами разработки.
Первая версия «была сфокусирована на инкрементальных изменениях в существующих репозиториях», таких как исправление ошибок или небольшие запросы функций. Android Bench 2.0 нацелен на «задачи большой сложности, на выполнение которых у инженера уходит несколько дней или даже неделя», например, добавление новых функций, создание приложений с нуля и портирование кроссплатформенных приложений на Android.
Этот новый фокус потребовал «более тонкой оценки и подсчета баллов», выходящих за рамки простой оценки «пройдено / не пройдено». Google переходит от бинарной системы к непрерывному оцениванию:
Мы рассчитываем этот процент выполнения на основе комбинации факторов, таких как функциональность, визуальная точность и предотвращение регрессий. Мы также применяем объективные штрафные баллы за отклонения от инструкций по оценке или структурных ограничений.
Google оценила модели Gemini 3.7/3.8 Flash, OpenAI GPT-6, Anthropic Fable 5.1, Kimi K3 и Qwen 3.8 Max. GPT-6 Astra занимает верхнюю строчку бенчмарка с показателем успешного прохождения в 28% (по сравнению с результатами в районе 90% при использовании предыдущего подхода).
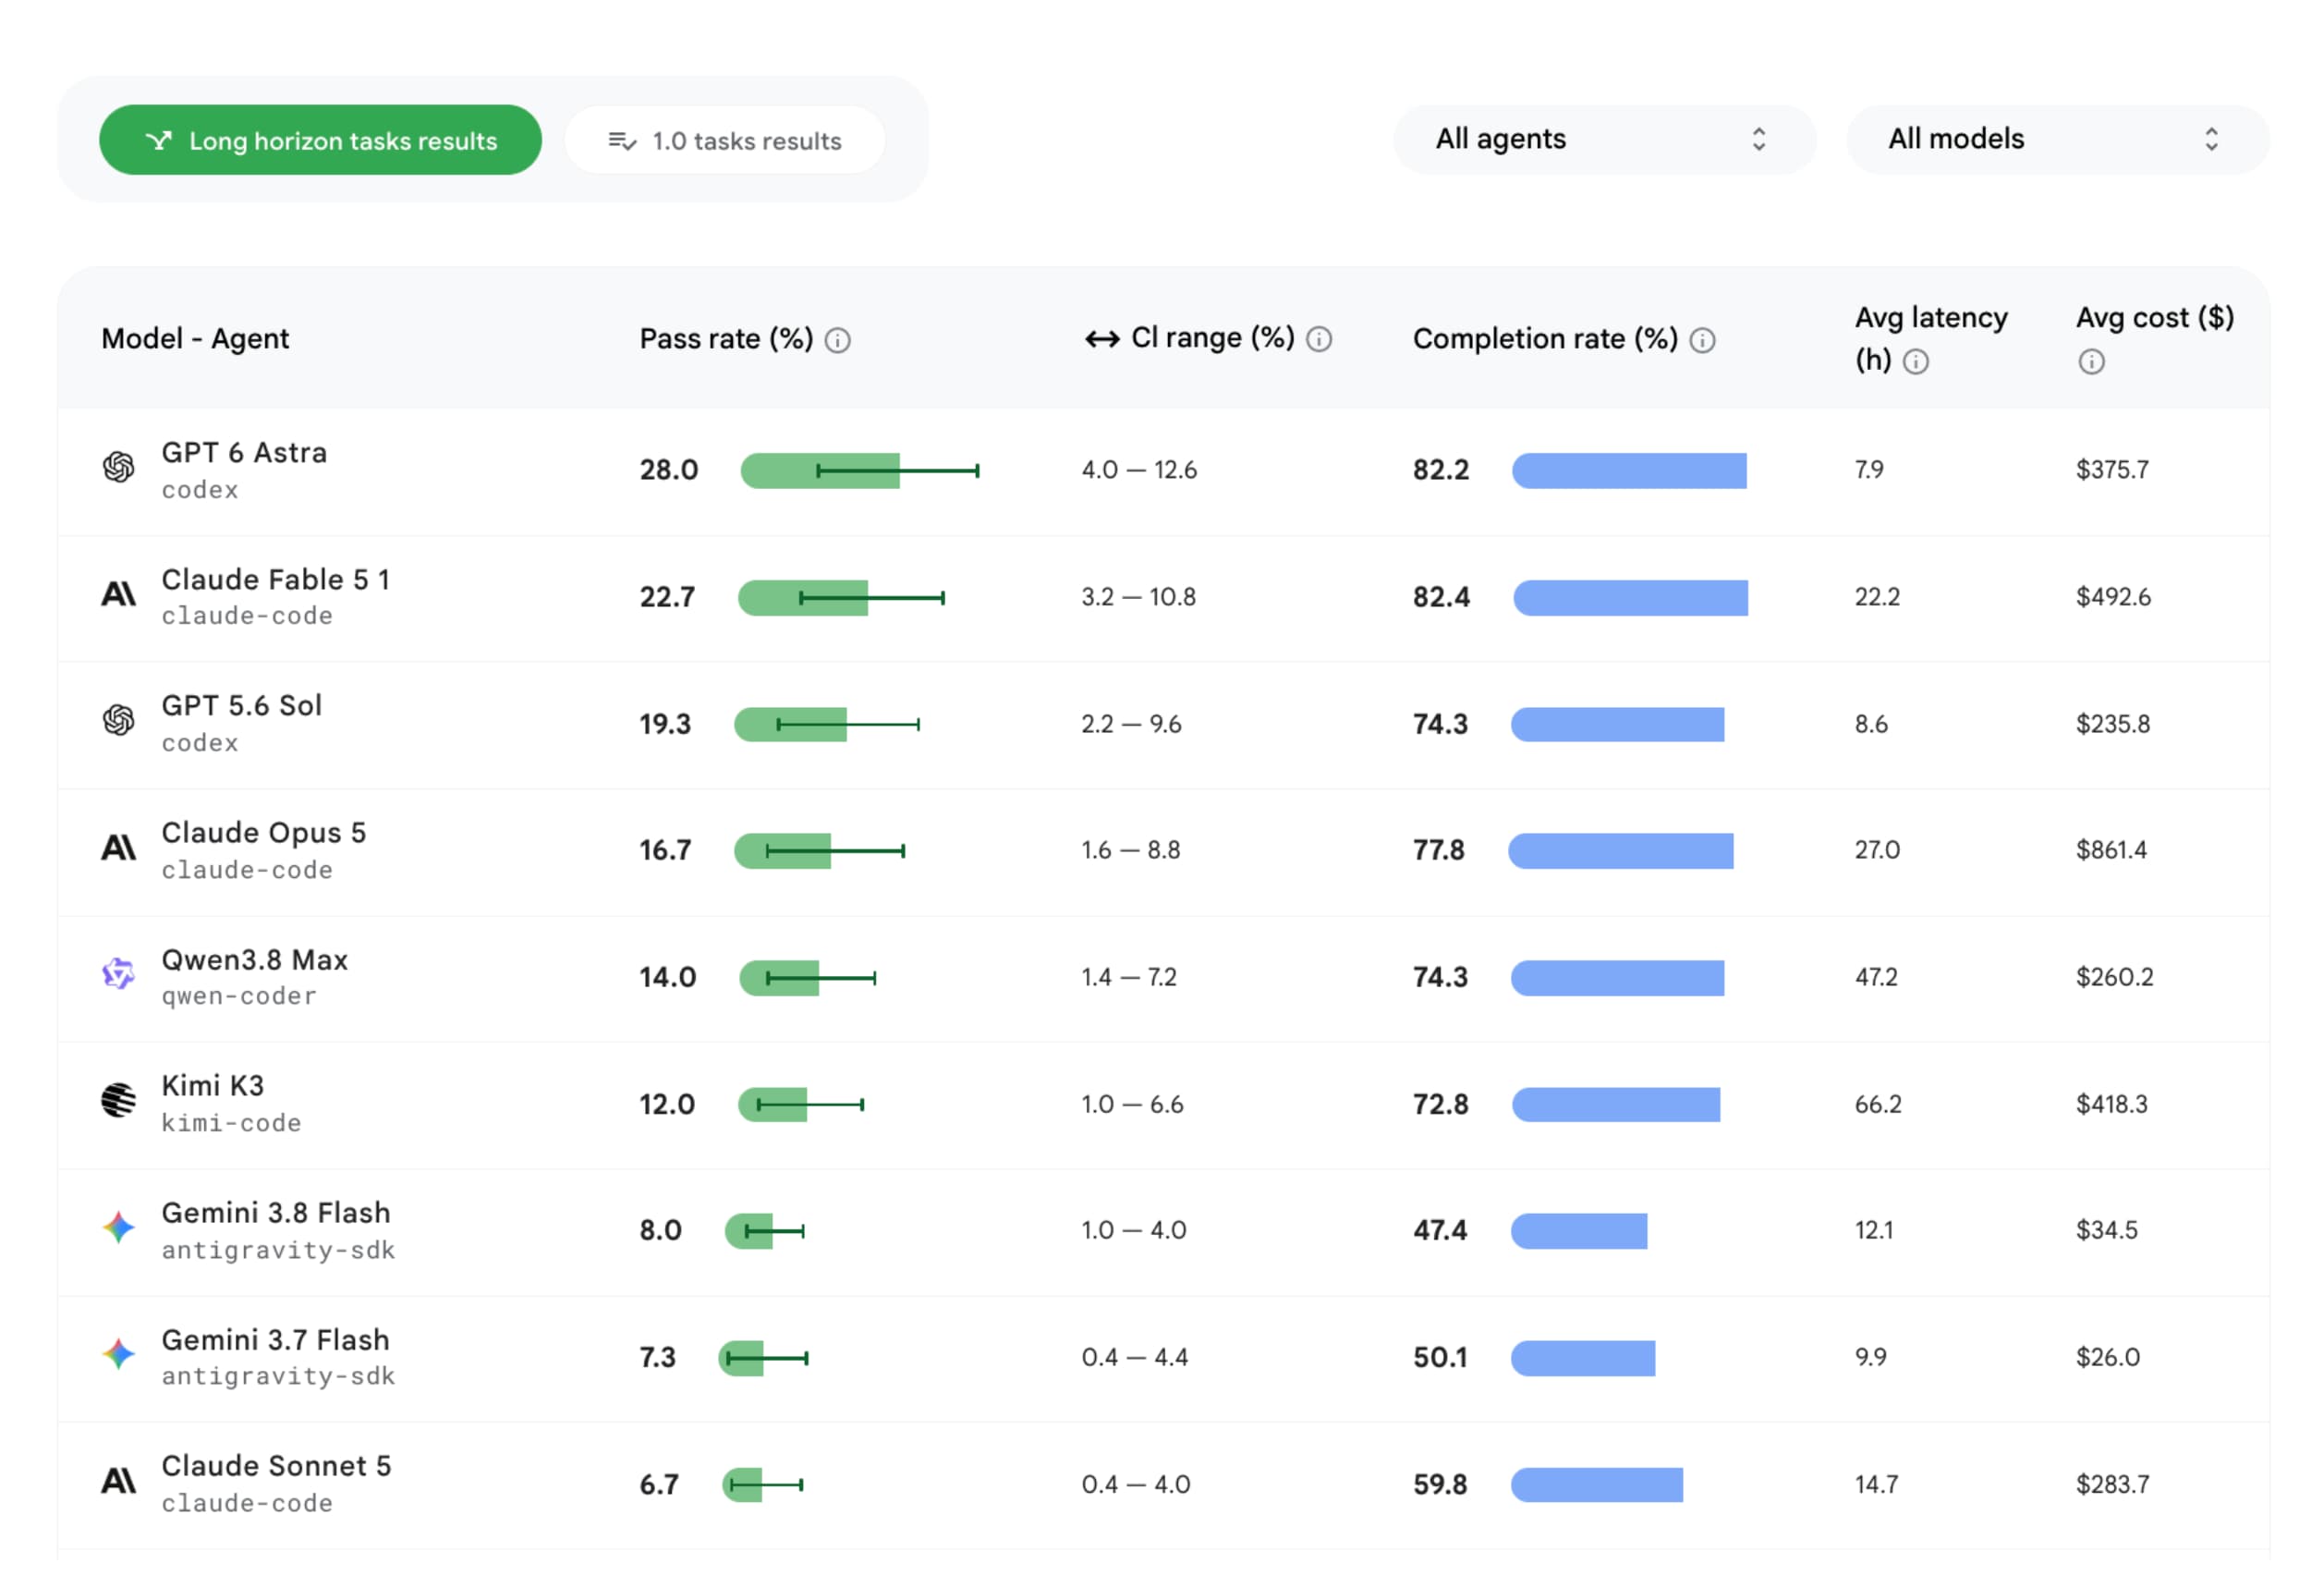
Google поделилась такими наблюдениями, как то, что «портирование кроссплатформенных приложений на Android остается открытой проблемой — ни одна модель не достигает 100% уровня успешности, а передовые модели показывают коэффициент выполнения не более 80%».
- «…ИИ лучше справляется с написанием нового кода, чем с рефакторингом существующего. Рефакторинг и миграция становятся сложнее, поскольку успех зависит от архитектурной сложности, а не от объема кода».
- «Модели демонстрируют сильные возможности в хорошо изученных, детерминированных трансформациях, таких как конвертация Java в Kotlin, замена Retrofit на Ktor или внедрение слоя ViewModel».
- «…Модели испытывают трудности, когда задачи требуют валидации во время выполнения (например, отсутствующие графы внедрения зависимостей), включают критические изменения в фреймворках или сталкиваются с пробелами в знаниях о невыпущенных библиотеках».
В рамках оценки агентов Android Bench запускал «агентов от соответствующих поставщиков моделей», таких как Gemini 3.8 Flash на Google Antigravity и GPT-5.6 Sol с Codex. В Google заявляют, что «архитектура обвязки (harness design) положительно влияет на результаты разработчиков», и в будущем в Android Bench планируется включить различные комбинации моделей и агентов.